El arquitecto que nunca duerme: así funciona AWS Well-Architected Agent
Octubre de 2026: AWS metió en preview un servicio que hace algo que hasta ahora solo hacía un humano con horas por delante — revisar una cuenta de AWS completa contra el Well-Architected Framework y decirte, con evidencia, qué está mal. Se llama Well-Architected Agent. En el video de esta semana lo cubrí rápido, en formato short. Acá quiero quedarme un rato más: cómo decide qué mostrarte primero, qué parte del trabajo del arquitecto realmente reemplaza, y por qué yo todavía le pondría un humano revisando atrás.
El problema que resuelve
El Well-Architected Framework no es nuevo — es la checklist de referencia de AWS para costo, seguridad, performance, resiliencia y hace años también sostenibilidad. El problema nunca fue la checklist: fue aplicarla. Un arquitecto se sentaba, pilar por pilar, servicio por servicio, y cruzaba manualmente configuración contra recomendación. En una cuenta chica, esto se hace en un día. En una cuenta con cientos de aplicaciones y miles de recursos, se vuelve un proyecto de semanas — y para cuando terminas, parte de lo que revisaste ya cambió.
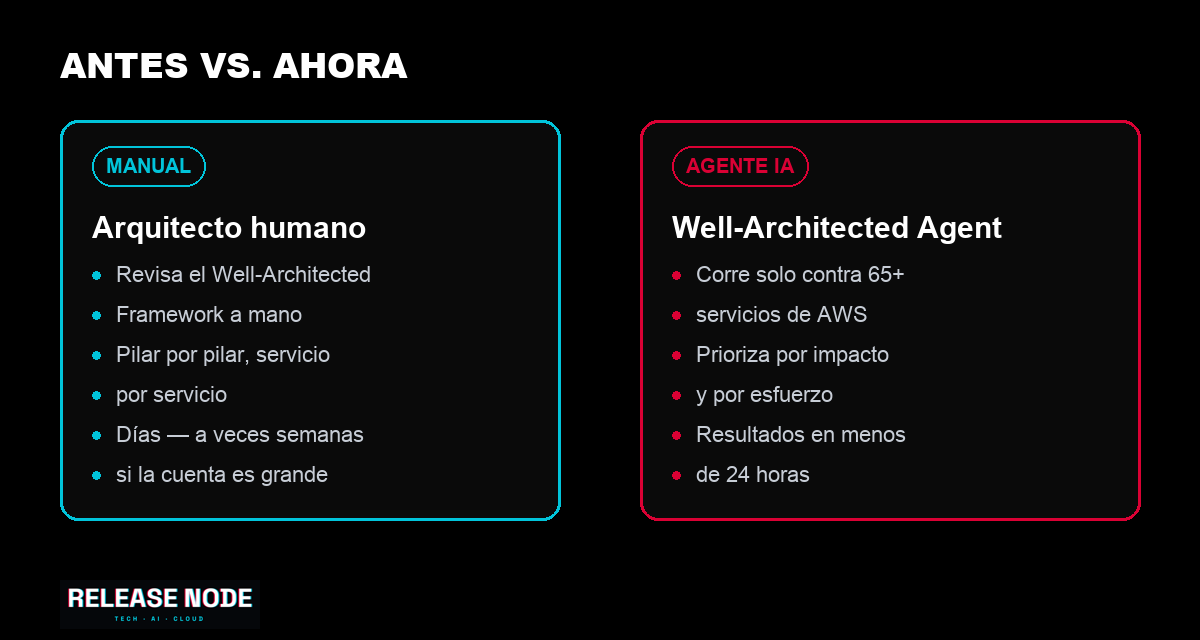
Well-Architected Agent ataca exactamente ese cuello de botella: no la checklist, sino el tiempo que toma recorrerla a mano.
Cómo decide qué priorizar — esto es lo que no cabía en el short
Lo primero que haces es onboardear el agente: no lo apuntas a "toda tu organización" y listo. Creas lo que AWS llama un agent profile, donde defines el alcance — qué cuentas, qué aplicaciones, y qué pilares del framework te importan de verdad para ese scope. Esa configuración inicial es la que determina todo lo que viene después; dos equipos con la misma cuenta pero distinto agent profile van a recibir hallazgos distintos, a propósito.
Con ese scope definido, el agente corre un análisis que correlaciona tres cosas a la vez: métricas de uso real, configuración de los recursos, y topología de la aplicación — contra más de 65 servicios de AWS. No es un linter de configuración estática; está mirando cómo se usa lo que tienes desplegado, no solo cómo está declarado. Eso es lo que le permite decir "esto importa" en vez de solo "esto está mal según el manual".
El resultado llega en menos de 24 horas, y viene priorizado por impacto y por esfuerzo contra las metas que tú le diste en el agent profile — no contra una tabla de puntaje genérica. Si configuraste el scope para priorizar resiliencia, un hallazgo de tres dólares de costo mal optimizado no va a aparecer antes que un single point of failure.
Tres niveles de hallazgos
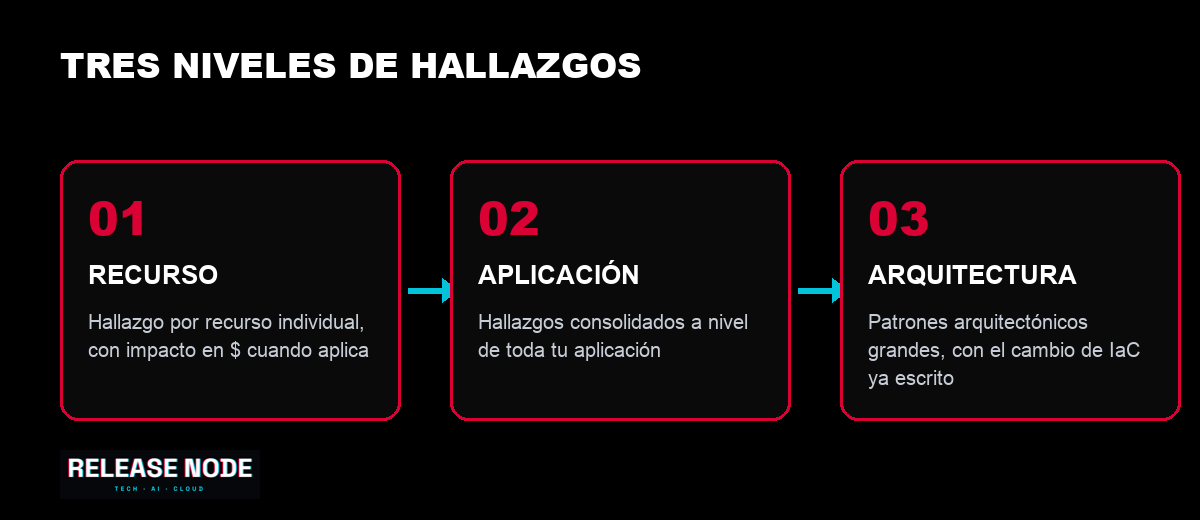
El agente entrega resultados en tres capas:
- Hallazgos por recurso individual, con el impacto en dólares cuando aplica.
- Hallazgos consolidados a nivel de aplicación completa, el mismo problema repetido en diez recursos se ve como un patrón, no como diez alertas sueltas.
- Patrones arquitectónicos más grandes, a este nivel el agente ya entrega el cambio de Infraestructura como Código escrito, no solo la descripción del problema.
Y para aplicar cualquier fix, el canal queda a tu elección: consola paso a paso, el cambio de IaC directo, o línea de comandos. El agente no te obliga a su propio flujo de remediación.
El ejemplo que puso AWS en su propio anuncio
El caso que AWS usó en su propio anuncio: un equipo marca resiliencia como prioridad, y el agente recomienda failover multi-AZ para una base de datos crítica que corría en una sola zona. No se queda en el diagnóstico — entrega el runbook de Systems Manager (SSM) que automatiza el cambio, y además un análisis cruzado que muestra el impacto en costo y en performance antes de que aprietes el botón.
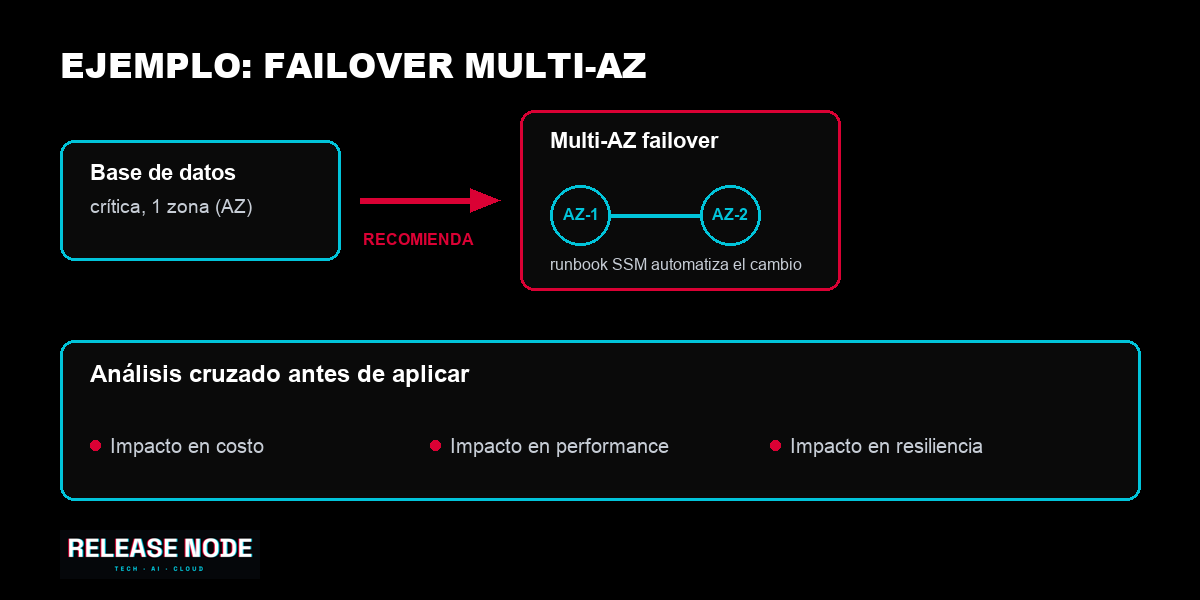
Esto es lo que diferencia al agente de una alerta tradicional: no solo te dice qué está mal, te entrega el camino completo para resolverlo — el runbook listo para ejecutar y el contexto de qué más se mueve (costo, performance) cuando lo aplicas. La decisión queda en tus manos, pero llega con todo el trabajo de análisis ya hecho.
La letra pequeña
- Está en preview, no en disponibilidad general.
- El agente en sí solo corre desde tres regiones: US East (N. Virginia), US East (Ohio) y US West (Oregon). Puedes onboardear workloads de cualquier región comercial de AWS, pero el análisis se ejecuta desde esas tres — así que hay una capa extra de datos cruzando región si tu carga vive en otro lado.
- Necesitas un plan de AWS Support activo — lo entrega el equipo de Support, no es un servicio independiente que compras aparte.
Para qué sirve, en la práctica
En el video cerré con que esto automatiza "el trabajo más aburrido y más caro de tener mal hecho". La utilidad concreta está en los tres niveles trabajando juntos: los hallazgos de nivel 1 y 2 (recurso y aplicación) te dan visibilidad inmediata y verificable — impacto en dólares que puedes chequear contra tu propia factura, sin tener que recorrer la cuenta servicio por servicio. El nivel 3 es el que más tiempo le ahorra a un equipo de arquitectura: convierte "sabemos que esto está mal diseñado" en un cambio de IaC concreto, listo para revisar y aplicar, en vez de un hallazgo que alguien tiene que traducir a código desde cero.
El agent profile es lo que hace que esto escale bien entre equipos: cada cuenta o aplicación puede tener su propio scope y sus propias prioridades de pilar, así que el mismo agente sirve igual de bien para un equipo que vive pendiente del costo que para uno que vive pendiente de resiliencia — sin que uno le mande ruido al otro.
Si administras cuentas de AWS y ya pagas Support, es una herramienta que vale la pena tener corriendo: te entrega en horas lo que antes tomaba días de revisión manual, con el fix ya armado y el trade-off ya calculado.
Fuentes
- Announcing AWS Well-Architected Agent — AWS Blog
- AWS Well-Architected Agent is now available in preview — AWS What's New
Video original: "El arquitecto que nunca duerme — AWS Well-Architected Agent", canal Release Node.